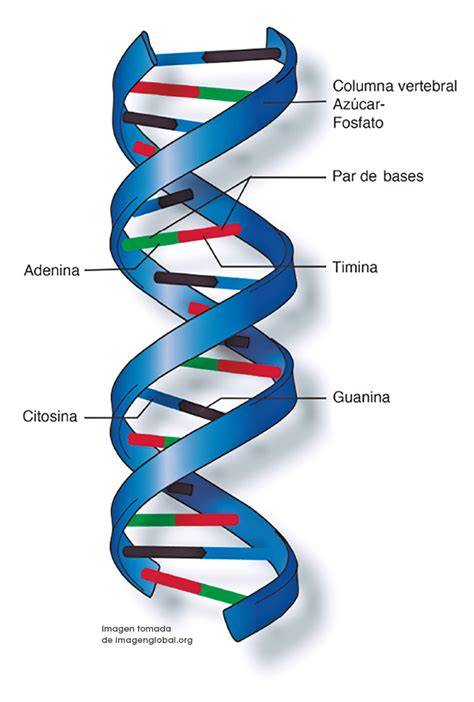
El ácido desoxirribonucleico (ADN) es la molécula que almacena la información hereditaria de los seres vivos. Su estructura tiene forma de doble hélice, semejante a una escalera de caracol: los pasamanos o columnas laterales están formados por moléculas de azúcar y grupos fosfato, mientras que los peldaños están constituidos por pares de bases nitrogenadas.
En concreto, los pasamanos del ADN están constituidos por una sucesión alternada de desoxirribosa y grupos fosfato. Cada desoxirribosa se une al siguiente azúcar mediante un grupo fosfato, formando dos cadenas largas de nucleótidos.
Qué es el ADN y dónde se encuentra
El ADN, o ácido desoxirribonucleico, es el material que contiene la información hereditaria en los humanos y casi todos los demás organismos.
Casi todas las células del cuerpo de una persona tienen el mismo ADN.
La mayor parte del ADN se encuentra en el núcleo celular (o ADN nuclear), pero también se puede encontrar una pequeña cantidad de ADN en las mitocondrias (ADN mitocondrial o ADNmt).
Las instrucciones que determinan todas las características y funciones de un organismo se encuentran en su material genético: el ADN (ácido desoxirribonucleico).
Todas las células, procariotas y eucariotas, contienen ADN en sus células.
En las células eucariotas el ADN está contenido dentro del núcleo celular, mientras que en las células procariotas, que no tienen un núcleo definido, el material genético está disperso en el citoplasma celular.
La composición de un nucleótido
El ácido desoxirribonucleico (ADN) es una larga molécula formada por una serie de unidades repetidas que al unirse, darán la famosa estructura de doble hélice o escalera de caracol.
Cada unidad, llamada nucleótido, está formada por un grupo fosfato, un azúcar (la desoxirribosa) y una base nitrogenada.
Cada base también está unida a una molécula de azúcar y una molécula de fosfato.
Juntos (una base, un azúcar y un fosfato) se llaman nucleótidos.
El ADN se compone de dos cadenas, cada una formada por nucleótidos.
Cada nucleótido, a su vez, está compuesto por un azúcar (desoxirribosa), un grupo fosfato y una base nitrogenada.
| Componente | Función o posición en la molécula |
|---|---|
| Desoxirribosa | Azúcar que forma parte de cada nucleótido y de los pasamanos del ADN. |
| Grupo fosfato | Une una desoxirribosa con la siguiente y forma, junto con el azúcar, las columnas laterales. |
| Base nitrogenada | Forma los peldaños de la escalera al unirse con una base complementaria. |
De qué están constituidos los pasamanos del ADN
El fosfato va a unir una desoxirribosa con la siguiente, formándose así una cadena simple de ADN.
Las desoxirribosas (azúcares) y los grupos fosfato constituyen las columnas de la molécula.
Siguiendo con el símil de la escalera de caracol, tendríamos una barandilla (los grupos fosfato y la desoxirribosa) y medio escalón (la base nitrogenada).
La estructura de doble hélice del ADN puede compararse, por tanto, con una escalera retorcida. Los dos pasamanos están formados por el esqueleto de azúcar-fosfato, y los peldaños se sitúan entre ambas cadenas.
Izquierda: Estructura química del ADN en la que se puede ver la posición de los grupos fosfato, las desoxirribosas y la interacción entre las dos parejas de bases nitrogenadas (A-T; C-G).
Derecha: Estructura espacial del ADN en forma de doble hélice o escalera de caracol: las “barandillas” naranjas están formadas por los grupos fosfato y las desoxirribosas; los “escalones horizontales” están constituidos por dos bases nitrogenadas complementarias.
Las bases nitrogenadas forman los peldaños
La información en el ADN se almacena como un código compuesto por cuatro bases químicas, adenina (A), guanina (G), citosina (C) y timina (T).
Las bases nitrogenadas son cuatro: adenina (A), timina (T), citosina (C), y guanina (G), y siempre una A se enfrenta a una T y una C se enfrenta a una G en la doble cadena.
El término par de bases alude a los bloques que construyen las cadenas de ADN.
Así, cada molécula de ADN está formada por dos hebras, y hay cuatro tipos de nucleótidos presentes en el ADN: A, C, T y G.
Cada uno de los nucleótidos de una hebra es complementario o interacciona con un nucleótido específico de la otra hebra, y así se mantiene unida la doble hélice.
Las bases de ADN se emparejan entre sí, adenina (A) con timina (T) y citosina (C) con guanina (G); para formar unidades llamadas pares de bases.
Las bases enfrentadas se dice que son complementarias.
Si, por ejemplo, tenemos una G en una hebra, en la otra hebra siempre habrá una C con la que interactúa.
Si, en cambio, hay una T, su pareja en la otra hebra será la A.
Así, los nucleótidos siempre se complementan.
La doble hélice de ADN con las bases nitrogenadas complementarias que se ubican hacia dentro y establecen uniones no covalentes (o fuerzas de atracción) entre sí que mantienen la estructura de la molécula.
Para que esta estructura sea más estable, se unen dos moléculas de ADN complementarias mediante puentes de hidrógeno (una unión no muy fuerte).
Como cada una tiene un tamaño diferente y sus átomos están en una posición distinta, para que nuestra escalera de caracol tenga las barandillas bien estables, una anchura constante y los dos tablones que constituyen los escalones estén bien encajados, las bases nitrogenadas, solo se unen formando dos parejas: la adenina se une con la timina, y la citosina con la guanina.
Así, cada peldaño de la escalera está formado por un par de tablones que encajan perfectamente (A-T o G-G).
Por lo tanto, teniendo solo una de las dos hebras de ADN, se puede deducir la secuencia de la otra.
Cómo se organiza la doble hélice
Los nucleótidos están dispuestos en dos hebras largas que forman una espiral llamada doble hélice.
El ADN adopta una forma de doble hélice, como una escalera caracol donde los lados son cadenas de azúcares y fosfatos conectadas por “escalones”, que son las bases nitrogenadas.
Las bases nitrogenadas complementarias se sitúan hacia el interior de la doble hélice, mientras que las moléculas de desoxirribosa y los grupos fosfato quedan hacia el exterior.
La unión repetida entre desoxirribosas y grupos fosfato origina el esqueleto de cada hebra. Las dos hebras se mantienen asociadas porque las bases nitrogenadas de una cadena interactúan con las bases complementarias de la otra.
El ADN, los cromosomas y la compactación
El ADN está organizado en cromosomas.
En las células eucariotas los cromosomas son lineales, mientras que los organismos procariotas, como las bacterias, presentan cromosomas circulares.
Para cada especie, el número de cromosomas es fijo.
Por ejemplo, los seres humanos tienen 46 cromosomas en cada célula somática (no sexual), agrupados en 23 pares, de los cuales 22 son autosomas y un par es sexual.
Una mujer tendrá un par de cromosomas sexuales XX y un varón tendrá un par XY.
Cada cromosoma tiene dos brazos, ubicados por arriba y por debajo del centrómero.
La molécula de ADN se asocia a proteínas, llamadas histonas, y se encuentra muy enrollada y compactada para formar el cromosoma.
Cuando los cromosomas se duplican, previo a la división celular, cada cromosoma está formado por dos moléculas de ADN unidas por el centrómero, conocidas como cromátidas hermanas.
La información hereditaria se encuentra en la secuencia de bases
El ADN tiene la función de “guardar información”.
Es decir, contiene las instrucciones que determinan la forma y características de un organismo y sus funciones.
Además, a través del ADN se transmiten esas características a los descendientes durante la reproducción, tanto sexual como asexual.
La información está guardada en el ADN en el código de secuencia de bases A, T, C y G que se combinan para originar “palabras” denominadas genes.
Los genes son fragmentos de ADN cuya secuencia nucleotídica codifica para una proteína.
Es decir que a partir de la información “escrita” en ese fragmento de ADN se fabrica (sintetiza) un tipo particular de proteína.
Aunque, en realidad, los genes también llevan la información necesaria para fabricar moléculas de ARN (ribosomal y de transferencia) que intervienen en el proceso de síntesis de proteínas.
Un gen no es una estructura que se vea sino que se define a nivel funcional.
Es una secuencia que va a empezar en algún lugar del ADN y va a terminar en otro.
Para conocer un gen se secuencia, se determina la cantidad de los nucleótidos que lo forman y el orden en que se ubican.
Todas las células de un organismo tienen el mismo genoma, o conjunto de genes.
Pero, en cada célula se expresan los genes que se usan.
Por ejemplo, aunque una célula de la piel tiene toda la información genética al igual que la célula del hígado, en la piel solo se expresarán aquellos genes que den características de piel, mientras que los genes que dan características de hígado, estarán allí “apagados”.
Por el contrario, los genes que dan rasgos de “hígado” estarán activos en el hígado e inactivos en la piel.
Lo que no se usa se encuentra mayormente compactado.
Este empaquetamiento puede ser temporal o definitivo.
La longitud del ADN y los pares de bases
Podemos contar el ADN y la cantidad de ADN, o su longitud, usando los pares de bases.
De este modo, cuando hablamos de un gen y queremos describir cómo es de grande, podríamos decir que este gen tiene una longitud de mil pares de bases.
Si se trata de un gen muy largo, podría tener 10.000 pares de bases o, lo que es equivalente, 10 kilobases.
El ADN humano consta de unos 3 mil millones de bases, y más del 99 por ciento de esas bases son iguales en todas las personas.
Replicación: cómo se copia la molécula
Una propiedad importante del ADN es que puede replicarse o hacer copias de sí mismo.
Cada hebra de ADN en la doble hélice puede servir como patrón para duplicar la secuencia de bases.
Cuando la célula se divide, cada nueva célula que se forma debe portar toda la información genética, que determine sus características y funciones.
Para eso, antes de dividirse, el ADN debe replicarse, es decir generar una copia de sí mismo.
Durante la replicación, la molécula de ADN se desenrolla, separando sus cadenas.
Cada una de éstas servirá como molde para la síntesis de nuevas hebras de ADN.
Para eso, la enzima ADN-polimerasa coloca nucleótidos siguiendo la regla de apareamiento A-T y C-G.
El proceso de replicación del ADN es semiconservativo, ya que al finalizar la duplicación, cada nueva molécula de ADN estará conformada por una hebra “vieja” (original) y una nueva.
La célula, al dividirse, ha de transmitir su información a las células hijas, lo que implica haber sintetizado con anterioridad moléculas de ADN idénticas a las suyas, sin equivocarse en el orden de las bases nitrogenadas.
Esto no se realiza mediante un sistema de fotocopias o de escaneado de la información, sino más bien mediante una copia manual de todas las moléculas de ADN: es la denominada replicación.
Aunque el sistema de replicación del ADN es muy fiable, se producen errores, ya que las moléculas son muy largas.
Por ejemplo, el cromosoma 1 humano, que es el más largo, tiene unos 220 millones de pares de bases.
Transcripción y traducción de la información genética
El proceso de síntesis de proteínas consta básicamente de dos etapas: la transcripción y la traducción.
En la primera etapa, las “palabras” (genes) escritas en el ADN en el lenguaje de los nucleótidos se copian o transcriben a otra molécula, el ARN mensajero (ARNm).
Luego, en la etapa siguiente, el ARNm se traduce al idioma de las proteínas, el de los aminoácidos.
Este flujo de información se conoce como el “dogma central de la biología”.
Transcripción
Durante la transcripción la enzima ARN polimerasa, copia la secuencia de una hebra del ADN y fabrica una molécula de ARN complementaria al fragmento de ADN transcripto.
El proceso es similar a la replicación del ADN, pero la molécula nueva que se forma es de cadena simple y se denomina ARN.
Se denomina ARN mensajero porque va a llevar la información del ADN hacia los ribosomas, las organelas encargadas de fabricar las proteínas.
El ARN (ácido ribonucleico) es una molécula con una estructura similar al ADN.
El ARN se diferencia del ADN en que es de cadena simple, en lugar del azúcar desoxirribosa tiene ribosa, y en lugar de la base nitrogenada timina, (T), tiene uracilo (U).
Traducción y código genético
La molécula del ARN mensajero se traslada a los ribosomas donde ocurre la etapa de traducción.
Durante esta etapa el ribosoma lee la secuencia de nucleótidos del ARN mensajero por tripletes o tríos de nucleótidos, denominados codones.
A medida que el ribosoma lee la secuencia de codones va formando una proteína, a partir de la unión de aminoácidos.
Según cuál es el codón que el ribosoma “lee” va colocando el aminoácido que corresponde.
Si se considera la combinación de cuatro bases tomadas de a tres, existe un total de 64 codones posibles.
Cada codón determina qué aminoácido se colocará en la proteína que se está fabricando.
De los 64 codones, 61 corresponden a aminoácidos y 3 son codones de terminación (stop), responsables de la finalización de la síntesis proteica.
El código genético o “diccionario” permite traducir la información escrita en el lenguaje de los ácidos nucleicos (nucleótidos) al lenguaje de las proteínas (aminoácidos), y es universal, o sea, es válido para todos los seres vivos.
Así, la secuencia ATG (AUG en el ARNm) codifica para el aminoácido metionina, y el codón TTT (UUU en el ARNm) codifica para el aminoácido fenilalanina en todos los organismos vivos.
Como sólo existen 20 aminoácidos en la naturaleza, varios codones pueden codificar para el mismo aminoácido.
Por ejemplo, al aminoácido glicina le corresponden los codones GGU, GGC, GGA y GGG.
Cada codón del ARNm es leído por otro ARN, llamado ARN de transferencia (ARNt), que actúa como un “adaptador” entre la información que lleva el ARNm y los aminoácidos que deben ir colocándose para formar la proteína correspondiente.
El ARNt es muy pequeño comparado con los ARNm y tiene una secuencia, denominada anticodón que aparea (es decir, es complementaria) con el codón.
Cada ARN de transferencia tiene un anticodón y “carga” un aminoácido en particular.
Por ejemplo, el ARNt que tiene el anticodón UCA, se aparea al codón AGU, y carga el aminoácido serina (Ser).
De la misma manera, el ARNt que carga tirosina (Tyr) se aparea, a través de su anticodón, con el codón UAC.
Así se va formando una cadena polipeptídica (proteína) a medida que los anticodones de los ARNt reconocen sus respectivos codones en el ARNm.
Este proceso de síntesis proteica ocurre en los ribosomas.
La función de las proteínas
Las proteínas son macromoléculas que cumplen funciones variadas.
Hay proteínas estructurales, otras son enzimas, otras transportan oxígeno como la hemoglobina, hay proteínas involucradas en la defensa inmunitaria, como los anticuerpos, otras cumplen funciones de hormonas como la insulina, etc.
Así como el ADN está compuesto a partir de nucleótidos, las proteínas están compuestas a partir de aminoácidos.
Hay 20 aminoácidos diferentes, y cada proteína tiene una secuencia de aminoácidos particular.
Replicación, complementariedad y reparación del ADN
La complementariedad de las bases no solo mantiene unidas las dos hebras, sino que también permite copiar la información genética y detectar ciertos daños o errores.
El ADN, es la molécula donde se almacena la información de la célula.
En consecuencia, su conservación es de vital importancia para los seres vivos, por lo que han desarrollado una serie de mecanismos para la detección y reparación de los daños producidos en el ADN.
Dependiendo del lugar donde se produzcan dichos daños, se pueden llegar a generar mutaciones, lo que hará que el archivo del ADN no tenga la información en perfectas condiciones y envíe mensajes erróneos a la célula.
Este hecho puede conllevar la muerte de la propia célula o el padecimiento de determinadas enfermedades.
Por eso, todos los seres vivos han desarrollado sistemas de reparación del ADN.
Reparación por escisión de bases
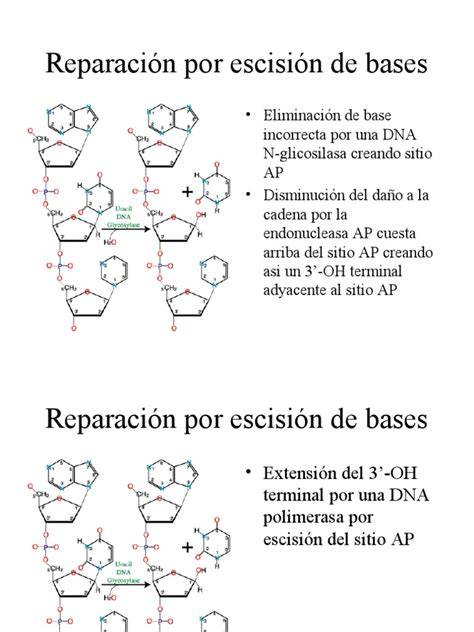
De este modo, descubrió el mecanismo de reparación por escisión de base, que repara los daños producidos en un único nucleótido de ADN, es decir en uno de los peldaños de nuestra escalera.
Generalmente, el daño es debido a las reacciones químicas que tienen lugar en la propia célula, aunque también puede ser debido a agentes externos.
Rellenar de nuevo el hueco con el nucleótido adecuado, tomando como referencia la base nitrogenada del nucleótido que está desemparejada.
Cabe destacar, que uno de los daños que repara este mecanismo, es el producido por la alquilación del ADN.
Aunque puede ser debida a reacciones celulares, muchos agentes anticancerígenos atacan las células tumorales mediante la alquilación de su ADN.
Por lo tanto, en estos casos, interesaría que las células tumorales no tuvieran activo el mecanismo de reparación por escisión de base, con el fin de que la quimioterapia fuera más efectiva.
Reparación por escisión de nucleótidos
Aziz Sancar ha centrado sus investigaciones en el estudio de la reparación de los daños del ADN causados por la luz ultravioleta.
Dicha radiación produce daños de mayor tamaño que las que hemos visto anteriormente: cuando hay dos escalones seguidos con T o C, en vez de estos tablones unirse con los de enfrente para formar el peldaño, interaccionan con el anterior o posterior de su propia cadena (son los dímeros de pirimidina).
En sus comienzos, Sancar investigó el mecanismo por el que se reparaban los dímeros de pirimidina en ciertas bacterias, gracias a una enzima llamada fotoliasa, que necesita la luz de color azul, para poder realizar la reparación.
En los mamíferos, la reparación se realiza mediante un mecanismo llamado reparación por escisión de nucleótidos, que elimina los daños de ADN voluminosos, entre otros los producidos por la radiación ultravioleta.
Por otro lado, el mecanismo reparación por escisión de nucleótidos, está regulado por el ritmo circadiano, en el que intervienen proteínas de la misma familia de las fotoliasas con las que Sancar comenzó sus investigaciones.
Reparación de errores de apareamiento
Paul Modrich, ha investigado una tercera vía de reparación que se produce principalmente cuando la propia célula hace una copia errónea de su ADN.
El mecanismo de reparación de mal apareamiento o reparación por mismatch, es el responsable de reparar los errores en la replicación, entre otros.
Aquí, los nucleótidos (los peldaños de nuestra escalera) no están dañados, pero al confundirnos de base, los dos tablones que han de conformar el escalón no encajan bien, lo cual es detectado por este mecanismo.
Cabe destacar, que los defectos en este mecanismo están asociados al cáncer de colon hereditario no polipósico, y que también juegan un papel en el desarrollo del 15 al 25% de los tumores espontáneos.
Relación entre el ADN y las enfermedades
Un dato importante a tener en cuenta es la estrecha relación que existe entre el daño del ADN y el padecimiento del cáncer.
De hecho, la causa más común de esta enfermedad es el daño del ADN debido a agentes externos, y la deficiencia en alguno de los sistemas de reparación del ADN está asociada a ciertos tipos de cánceres hereditarios.
Por otro lado, algunos de los fármacos anticancerígenos más utilizados, atacan las células malignas dañando su ADN.
El estudio de los mismos tiene importantes implicaciones en el conocimiento del origen de determinados tipos de cáncer y en una mejora de su tratamiento.
Por un lado, el fallo de estos sistemas de reparación está asociado a la aparición de ciertos tumores.
Importancia del ADN para la biotecnología
El conocimiento del ADN, su estructura y función, fue determinante para el desarrollo de la biotecnología moderna.
La estructura de doble hélice del ADN, que los investigadores James Watson y Francis Crick propusieran en el año 1953 proporcionó respuestas a muchas preguntas que se tenían sobre la herencia.
Predijo la autorreplicación del material genético y la idea de que la información genética estaba contenida en la secuencia de las bases que conforman el ADN.
Más aún, con el correr de los años y de las investigaciones, se pudo determinar que todos los seres vivos contienen un ADN similar, formado a partir de las mismas unidades: los nucleótidos.
Este código genético mediante el cual se “escriben” las instrucciones celulares es común a todos los organismos.
Es decir que el ADN de un ser humano puede ser “leído” dentro de una bacteria, y una planta puede interpretar la información genética de otra planta diferente.
A esta propiedad de la información genética se la conoce como “universalidad del código genético”.
El código genético universal es uno de los conceptos básicos para comprender los procesos de la biotecnología moderna.
Por ejemplo, la posibilidad de generar organismos transgénicos, y que las instrucciones del ADN de un organismo puedan determinar nuevas características en organismos totalmente diferentes.
Cuando los científicos comprendieron la estructura de los genes y cómo la información que portaban se traducía en funciones o características, comenzaron a buscar la forma de aislarlos, analizarlos, modificarlos y hasta de transferirlos de un organismo a otro para conferirle una nueva característica.
Justamente, de eso se trata la ingeniería genética, a la que podríamos definir como un conjunto de metodologías que nos permite transferir genes de un organismo a otro, y que dio impulso a la biotecnología moderna.
La ingeniería genética permite clonar (multiplicar) fragmentos de ADN y expresar genes (producir las proteínas para las cuales estos genes codifican) en organismos diferentes al de origen.
El ADN es la molécula en la que se encuentra la información de todos nuestros caracteres hereditarios (nuestros genes).
Esta información influye en prácticamente todo lo que somos: el color de ojos o piel, la tendencia a engordar, el tener una mayor o menor dificultad de aprendizaje, la tendencia a padecer ciertas enfermedades, etc.
Evidentemente, este patrón se va a ir modificando por el entorno en el que vivimos.
Aunque nuestros genes contengan la información de que podemos llegar a ser muy altos, si en la infancia no comemos lo suficiente, no alcanzaremos dicha altura.